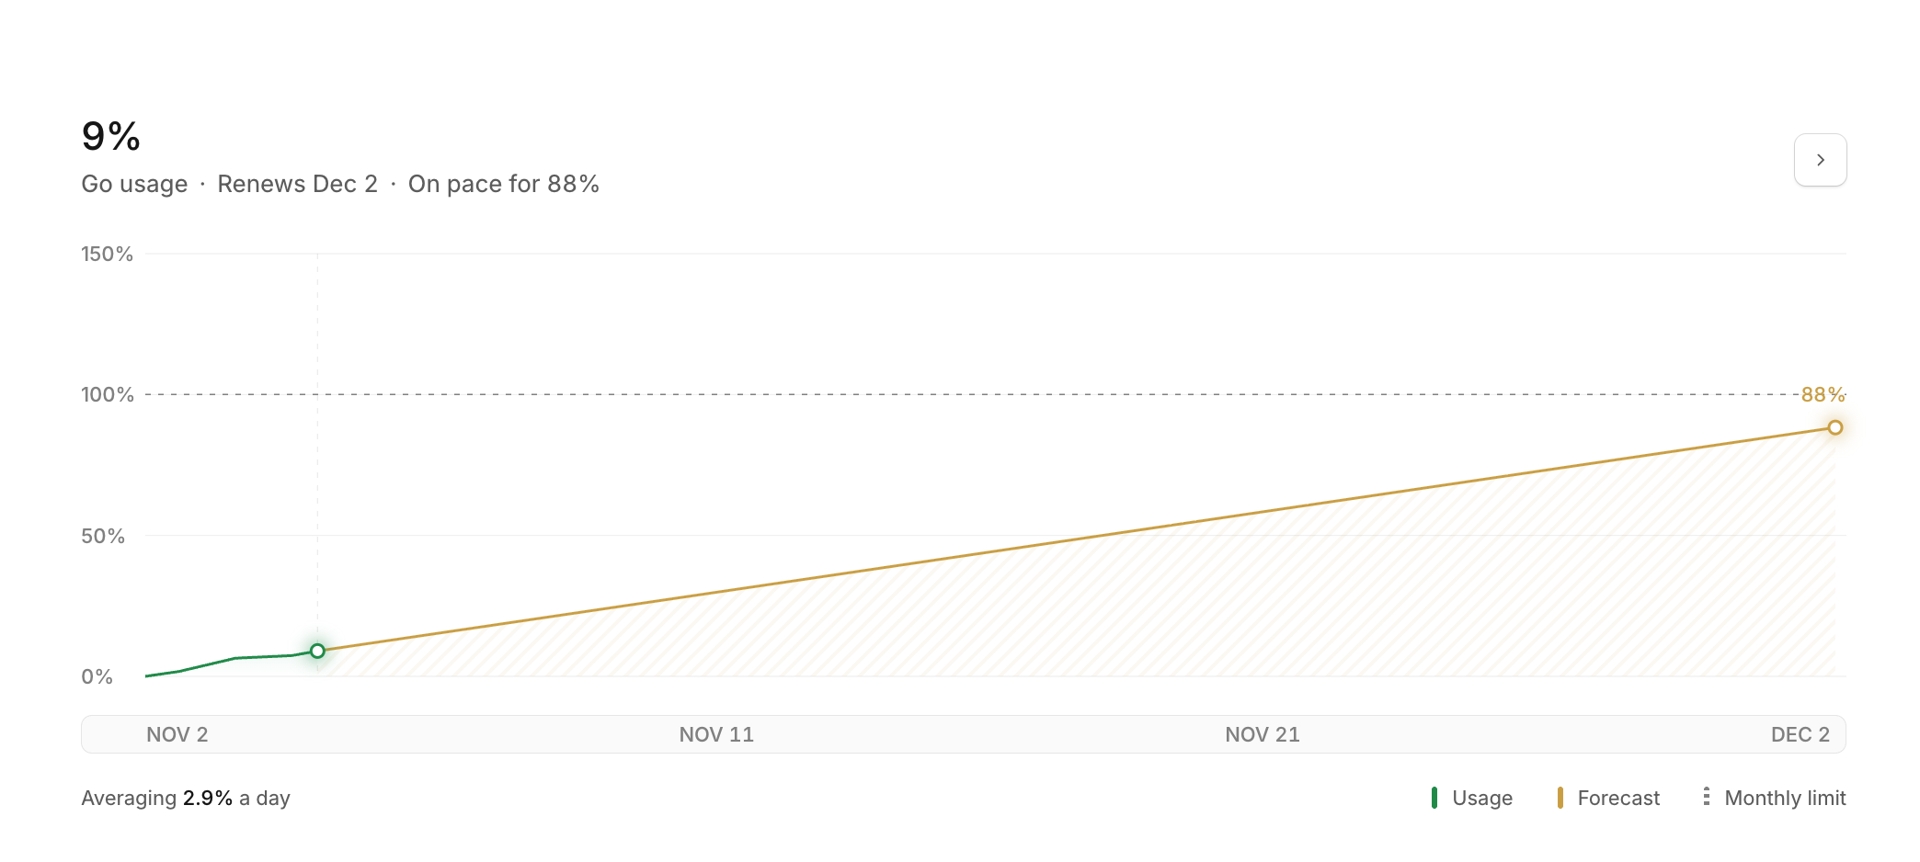
之前还各种费劲使用免费的模型,自从使用收费的coding plan以后,感觉花点钱换来模型的肆无忌惮的使用的感觉还是挺爽的。支持agent获取并配置自动提醒滚动 6% (11-05 19:25 重置,还有 1.9小时) ✅ 充足:预计用至 10% [已过 62%|默认窗口 5h] 本周 17% (11-09 08:00 重置,还有 3.6天) ✅ 充足:预计用至 35% [已过 49%|默认窗口 168h] 本月 8% (12-02 17:36 重置,还有 27.0天) ❔ 样本过少(窗口才过 10%),暂不估算【LiteLLM】2026-11-05(UTC 日 = 北京 11-05 08:00 ~ 11-06 07:59;当日已过 40%,数据截至 17:30) 请求 530(失败 0) tokens 103.68M 缓存命中 98.1% 渠道占比(按 tokens,从多到少) pi-macworker 68.65M 66.2% █████████████ pi-tecsun
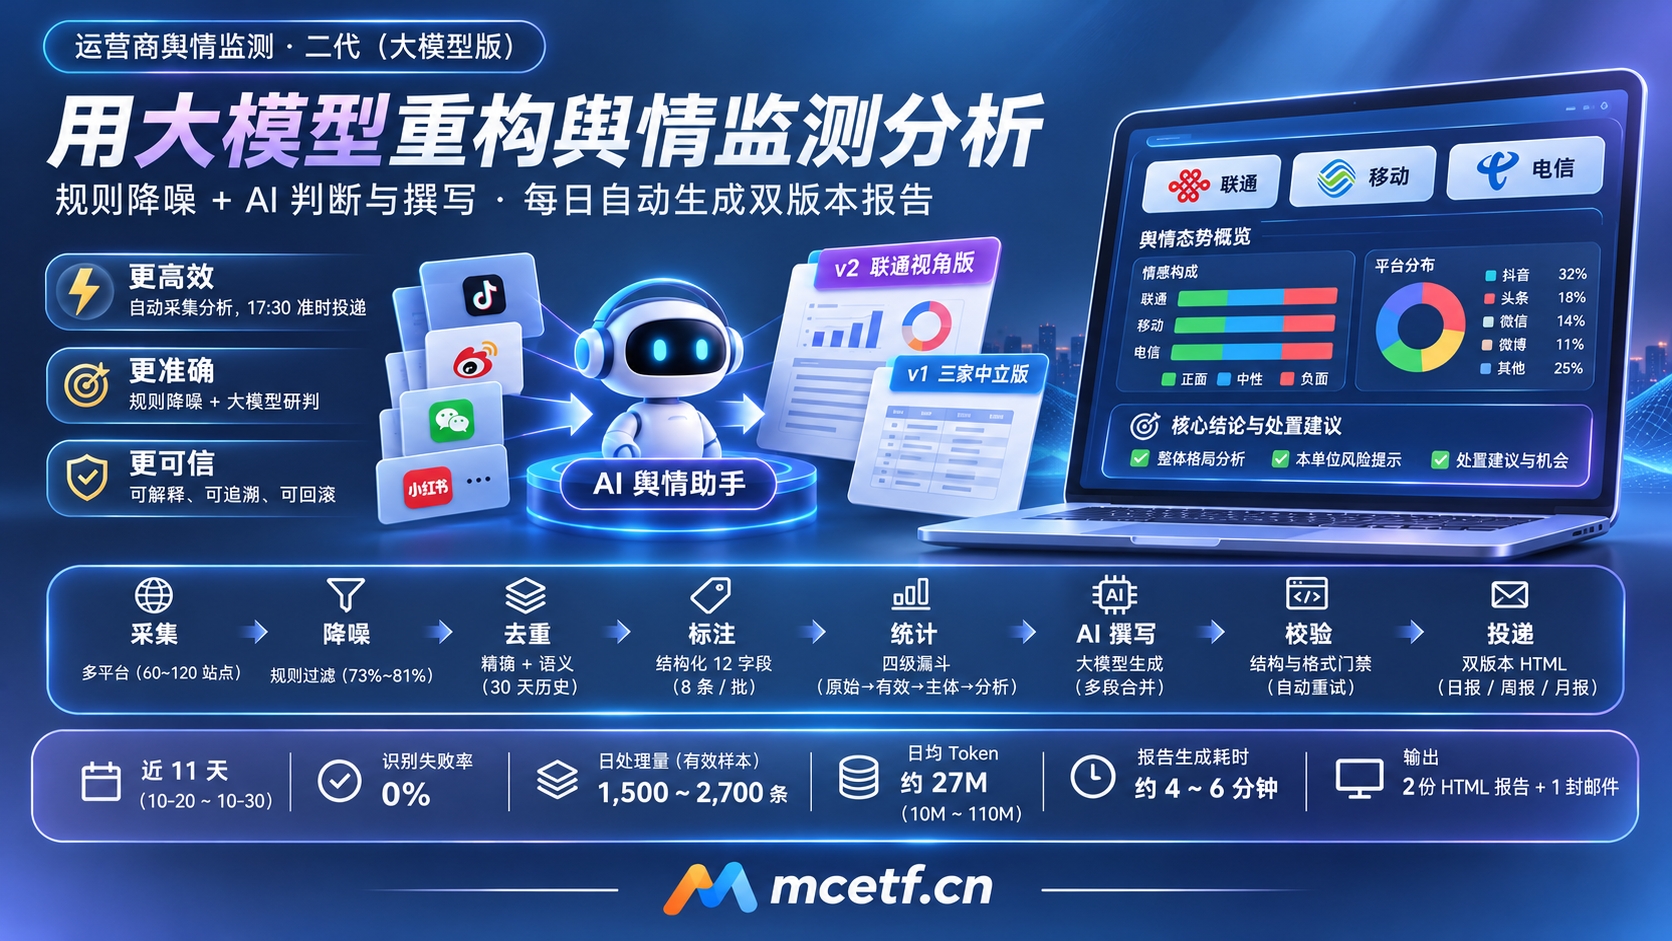
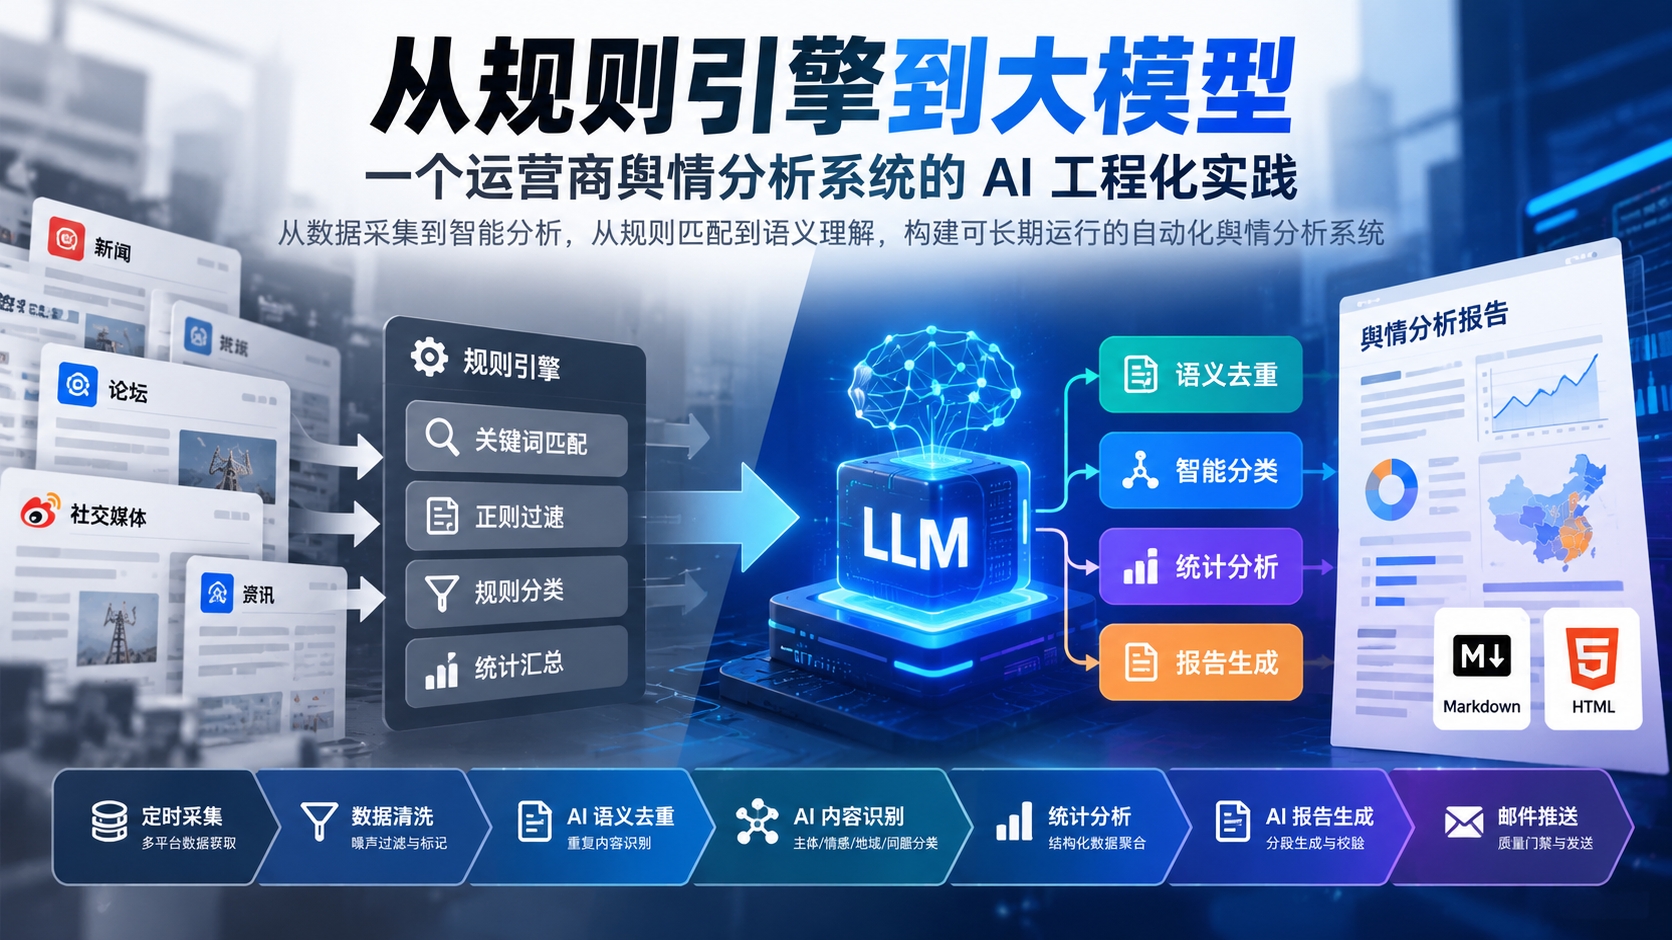
概要二代舆情系统已实现每天 17:30 自动完成“采集 → 分析 → 报告 → 投递”全链路,近 11 天(10-20 至 10-30)识别失败率为 0。分工原则:规则负责降噪,大模型负责判断与撰写。项目内容系统运营商舆情监测分析系统 · 二代(大模型版 / AI助理-舆情助手)记录依据2026 年 10 月技术评审材料监测范围电信 / 联通 / 移动,抖音、头条、微信、微博、小红书、快手、贴吧、投诉平台等 60\~120 个站点代码规模约 8,100 行;核心模块 fetcher / noise\_filter / dedup / annotate / ai\_client / stats / report / mail\_v2日处理量原始抓取数万条,有效样本 1,500\~2,700 条产出每期 2 份响应式 HTML 报告,一封邮件送达日均 token约 27M(中位),区间 10M\~110M背景与演进二代保留了一代的采集能力,把分析环节整体替换为大模型,目标是人只看结论与建议。人工处理的三个痛点:看不完:单日原始抓取可达数万条,70%\~80% 与运营商业务无关。判不准:同一
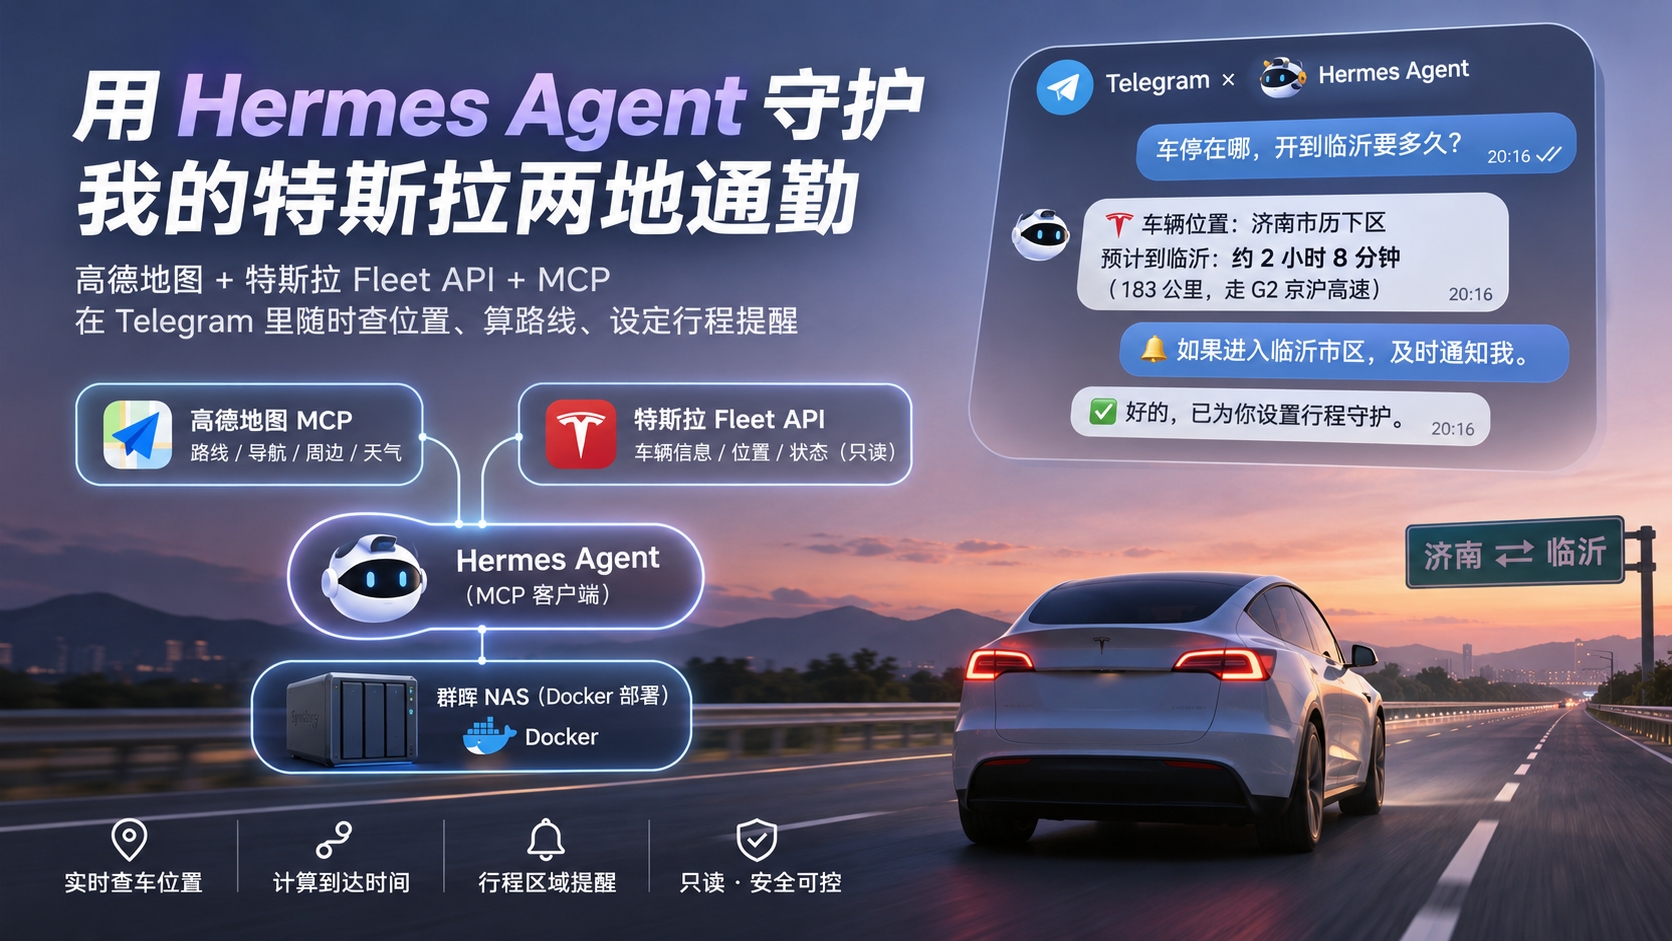
背景因为爱人在外地工作,每个周末都是特斯拉的两地通勤,对于是否平安到达的判断就是不时的拿出手机打开特斯拉的app查看车辆的位置。在全面ai、agent的情况下,肯定是可以让ai把这个事情搞定的,帮我盯好行程位置。现在在 Telegram 里问一句「车停在哪,开到临沂要多久」,它会先查车,再交给高德算路线。「如果进入某某区域,就及时发信息给我」Hermes就替我把整个过程守护了起来。我的助手是 Hermes Agent,部署在群晖 NAS 的 Docker 里,通过 Telegram 和我对话,模型请求统一走 LiteLLM。Hermes 内置 MCP(Model Context Protocol)客户端,外部能力以 MCP Server 的形式接进来,工具会自动注册成 mcp_<服务名>_<工具名>。这篇记录两件事:高德地图 MCP 的接入(十分钟搞定),以及特斯拉的接入(主线,涉及开发者注册、OAuth、自写 MCP 和几处踩坑)。文中所有密钥、车辆标识、域名和路径都做了替换。一、高德地图 MCP 接入高德官方提供远程 MCP 服务,走 Streamable
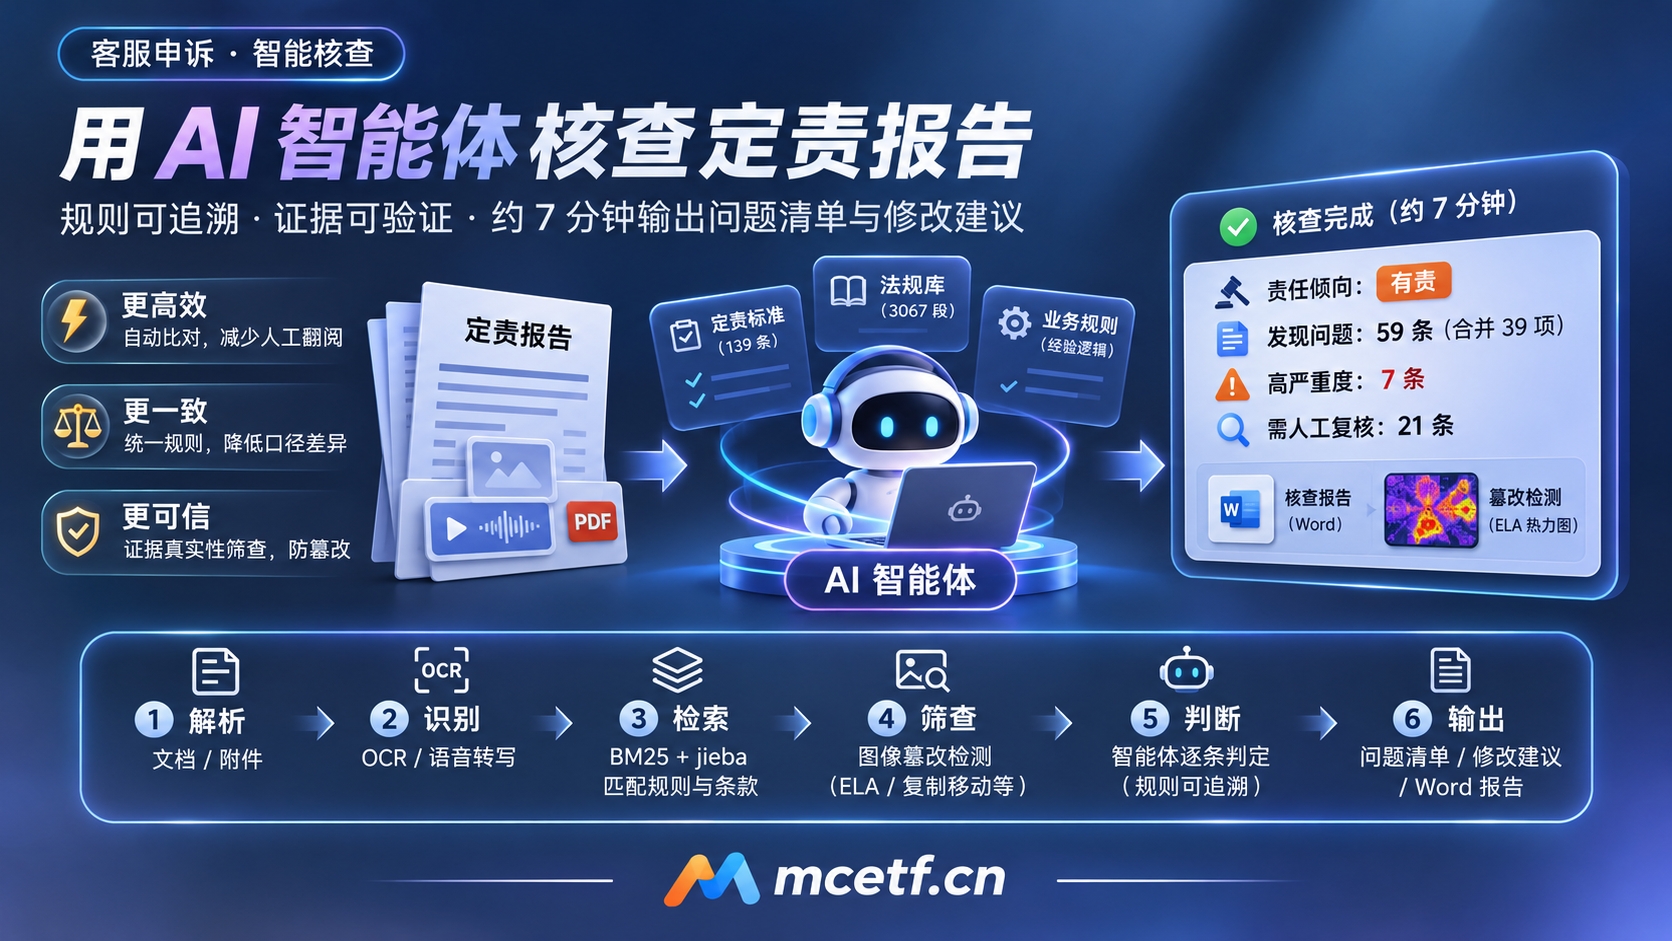
在客服申诉处理中,「定责报告」是否站得住脚,过去全靠人工对着标准逐条核。如果利用ai智能体来实现,往往采用的就是将技能和规则提供给智能体,但是在规则、报告篇幅、证据材料数据量过大的情况,会导致效果的严重下滑,上下文超长后的报错是直观的,更大的问题就是结果不可控制,每次执行因为不知道大模型记住、看到的是哪一部分,结果都是不一致。针对这个事情需要做的就是,将规则拆分后逐条规则让ai去确认,然后将最终报告拼接。当然这就是需要把这件事做成了自动化:上传报告和附件,约 7 分钟拿到问题清单和修改建议,每条结论都能追溯到规则和原文。这篇文章从开发思路、技术方案和实际效果三个角度做个总结。为什么要做人工核查有三个老问题:慢:对照标准逐条比对、反复翻附件,一份报告要花很长时间。尺度不一:不同人判断口径不同,同类案件结论难统一。证据难辨:截图、录音可能被 PS 或合成,肉眼很难发现。同时,这类数据涉及用户隐私,项目一开始就定了三条硬约束:数据不出内网:全流程在企业内网完成。只用内部大模型:技能本身不调用任何外部模型,推理交给企业自有的智能体平台。组件开源且离线:OCR、语音转写、篡改检测都选开源方案,本
本文档记录系统的整体架构、模块设计、模型使用策略与工程实践,已隐去接口地址、认证凭据、具体关键词表、服务器路径、邮件地址等敏感信息,可作为团队内部技术分享材料。一、项目定位与演进一个自动化的运营商舆情监测分析系统,每日定时采集公开网络舆情 → AI 识别归类 → 生成多维度分析报告 → 邮件推送。架构演进阶段形态说明一代规则引擎版采集后走规则管道(关键词/正则聚类)出报告二代(当前)LLM 版保留采集能力,分析环节整体替换为 AI关键整合决策:数据与程序分离数据目录:采集产物(原始 CSV、备份、报告)独立存放程序目录:全部代码、状态、日志集中管理好处:数据可独立备份/迁移,程序可独立升级/回滚。二、整体架构[定时触发 systemd timer] │ ▼ [编排层 run.py] ← 单实例锁(防止重复执行) │ ├─ 1. 采集阶段 ──→ 外部接口 → 原始 CSV ├─ 2. 噪声过滤 ──→ 标记(不删行) ├─ 3. AI 去重 ──→ 重复标记 ├─
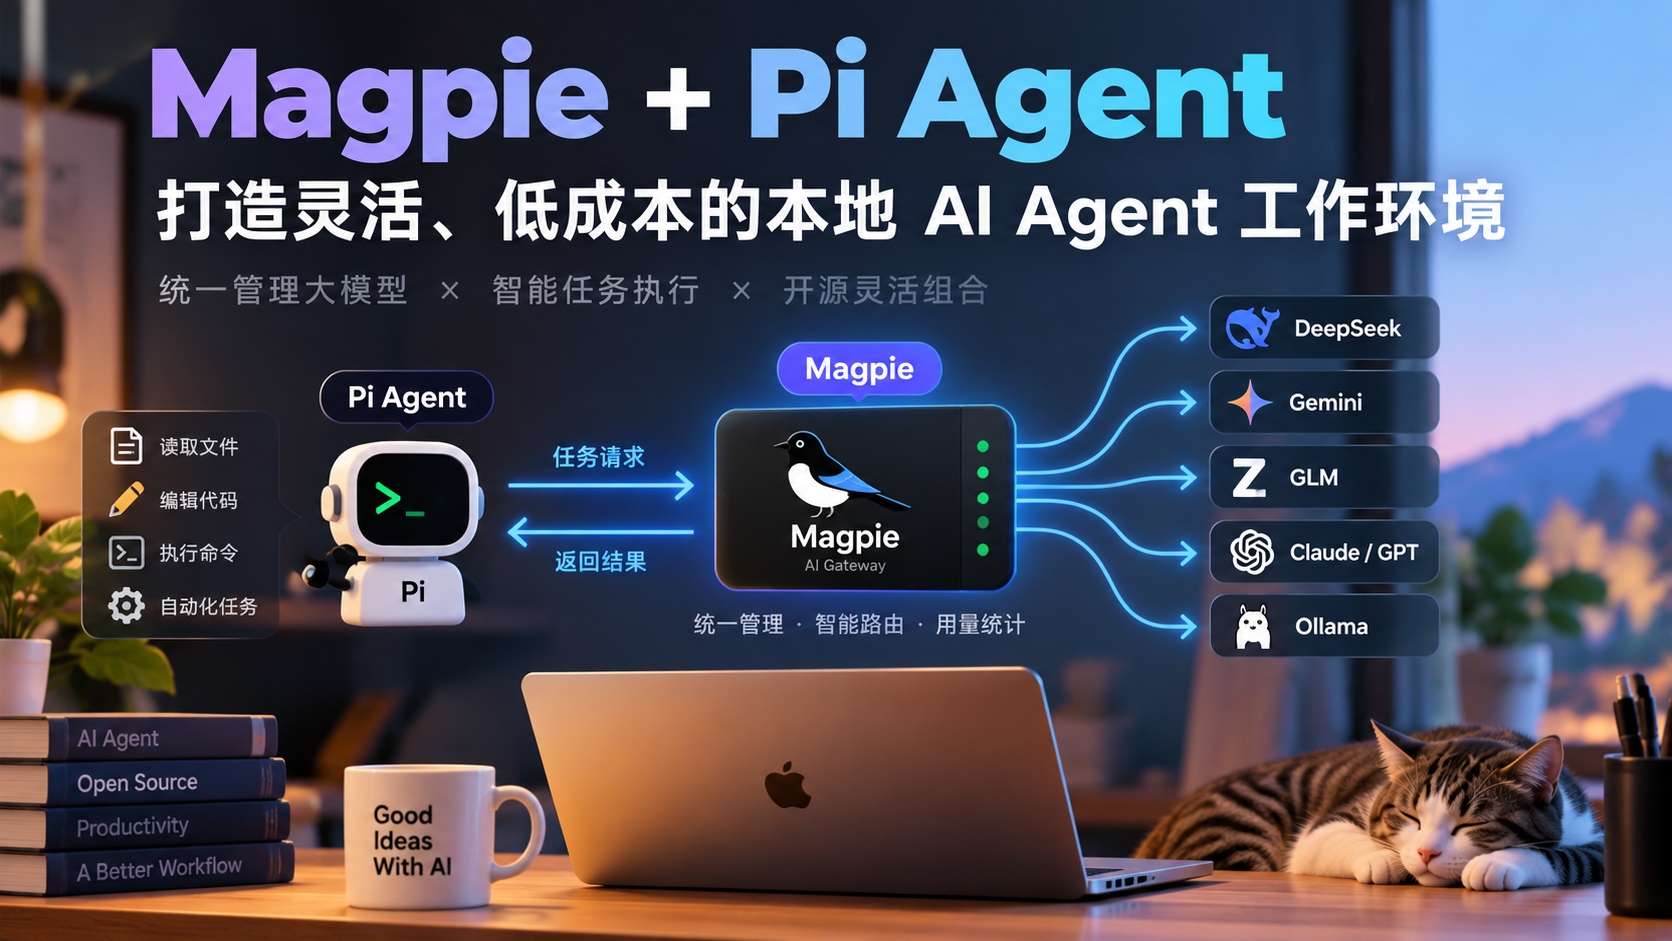
我认为当前最好的AI工具就是Magpie,它的强大不在于AI能力,而是它让AI的使用成本降低到了极致。对于AI的使用,无所顾及的使用和精打细算的使用的结果是不一样的,特别是针对高端的模型,能酣畅淋漓的使用将带来非常好的结果。此外,就是极度简化的pi agent,最近通过两者的结合,以极低的成本完成了稽核系统+AI的项目模型构建、客服舆情项目的开发。下面简单将安装过程记录下来。最近尝试了 Magpie + Pi Agent 的组合,发现两者能够很好地互补:Magpie 负责统一管理大模型,Pi Agent 负责调用模型完成实际任务。整个架构简单、轻量,而且具有很强的扩展性。一、Magpie:统一管理大模型的 AI 网关Magpie GitHub 项目Magpie 是一个开源的 AI 模型管理与网关工具,可以把不同厂商的大模型统一接入,为多个 AI Agent 提供模型服务。它的主要能力包括:统一模型管理:支持 DeepSeek、Gemini、GLM、Claude、GPT、Ollama 等模型。API 协议转换:兼容 OpenAI、Anthropic、Gemini 等接口协议。智能路由:可
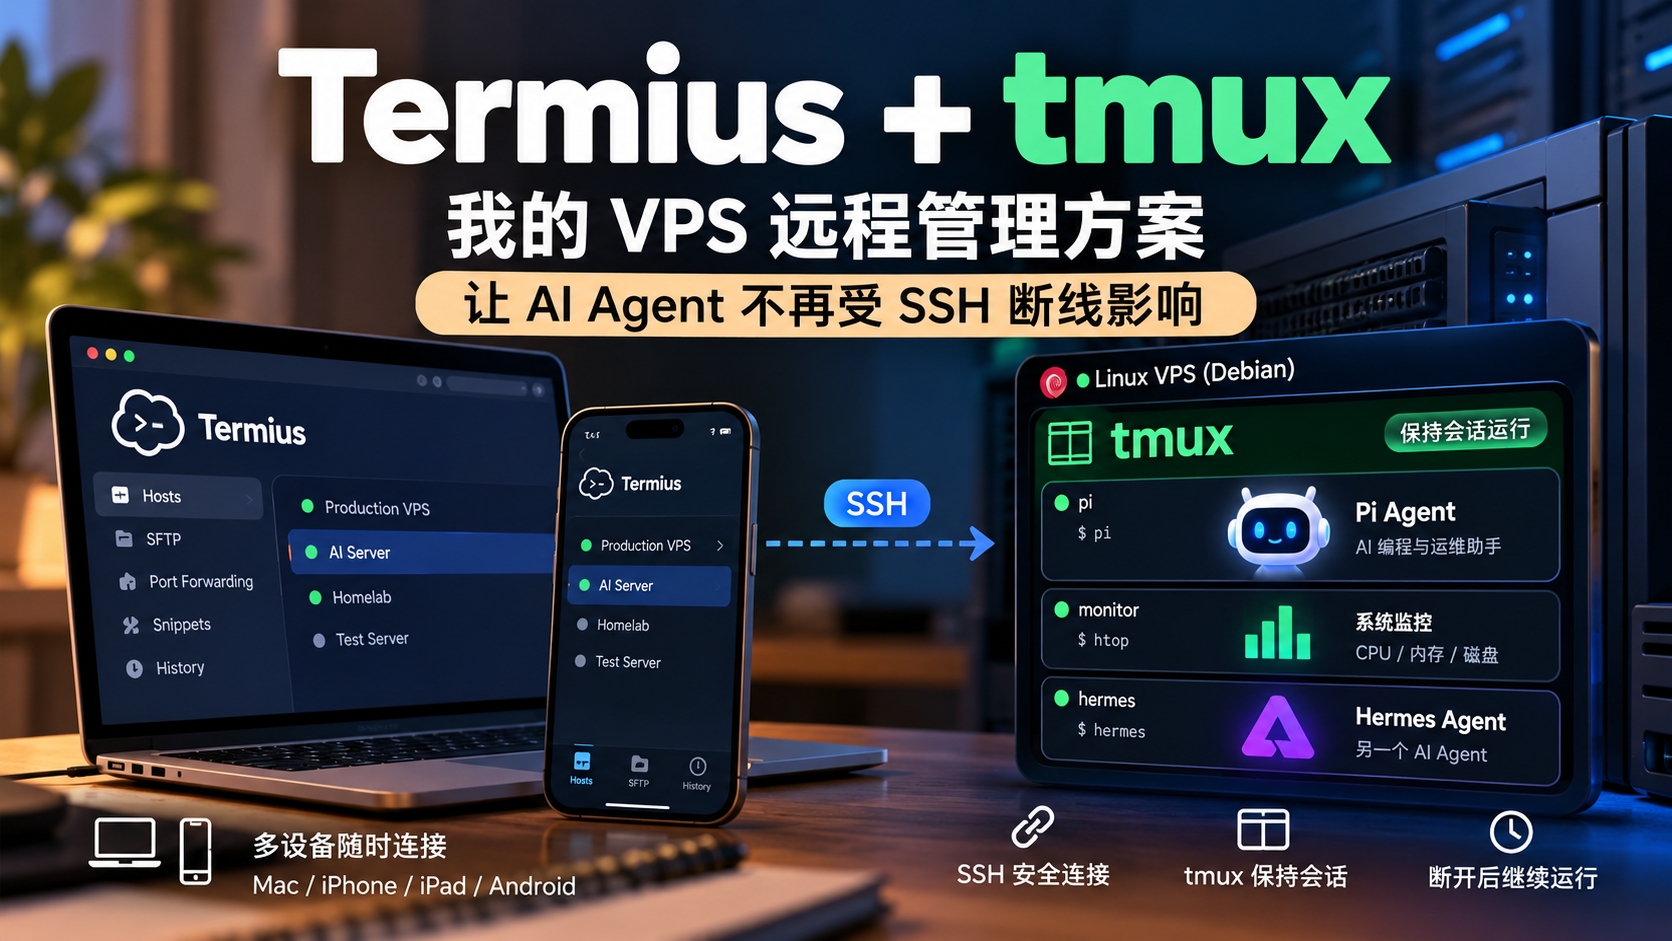
AI编程带来的变化就是你只需要脑子装好想做的事情,需要达到的效果,知道如何验证这个结果,剩下的就交给各种智能体来实现。你可以边旅游间歇性的查看一下处理的进度,做一个进度验收就可以了。但是这个方式存在的一个问题就是如何保持项目的连续性,如何ssh中断后重新登录后还可以延续之前的进程?下面就是我最近总结出来的高效率的组合:Termius + tmux:我的 VPS 远程管理方案最近,我在 Linux VPS 上部署了 Pi Agent、Hermes Agent 等 AI 工具,希望能够随时随地通过 Mac 或手机连接服务器,执行 AI 任务、检查运行状态和管理系统。在实际使用中遇到了一个问题:通过 SSH 启动 Pi Agent 后,如果关闭 SSH 客户端或者网络意外中断,正在运行的任务可能随之终止。经过一番尝试,我最终采用了 Termius + tmux 的组合。这套方案并不复杂,却很好地解决了远程终端的连接管理和任务持续运行问题。一、我的使用环境目前主要使用以下工具:组件用途Mac主要操作设备TermiusSSH 客户端,管理 VPS 连接Debian Linux VPS远程服务器,
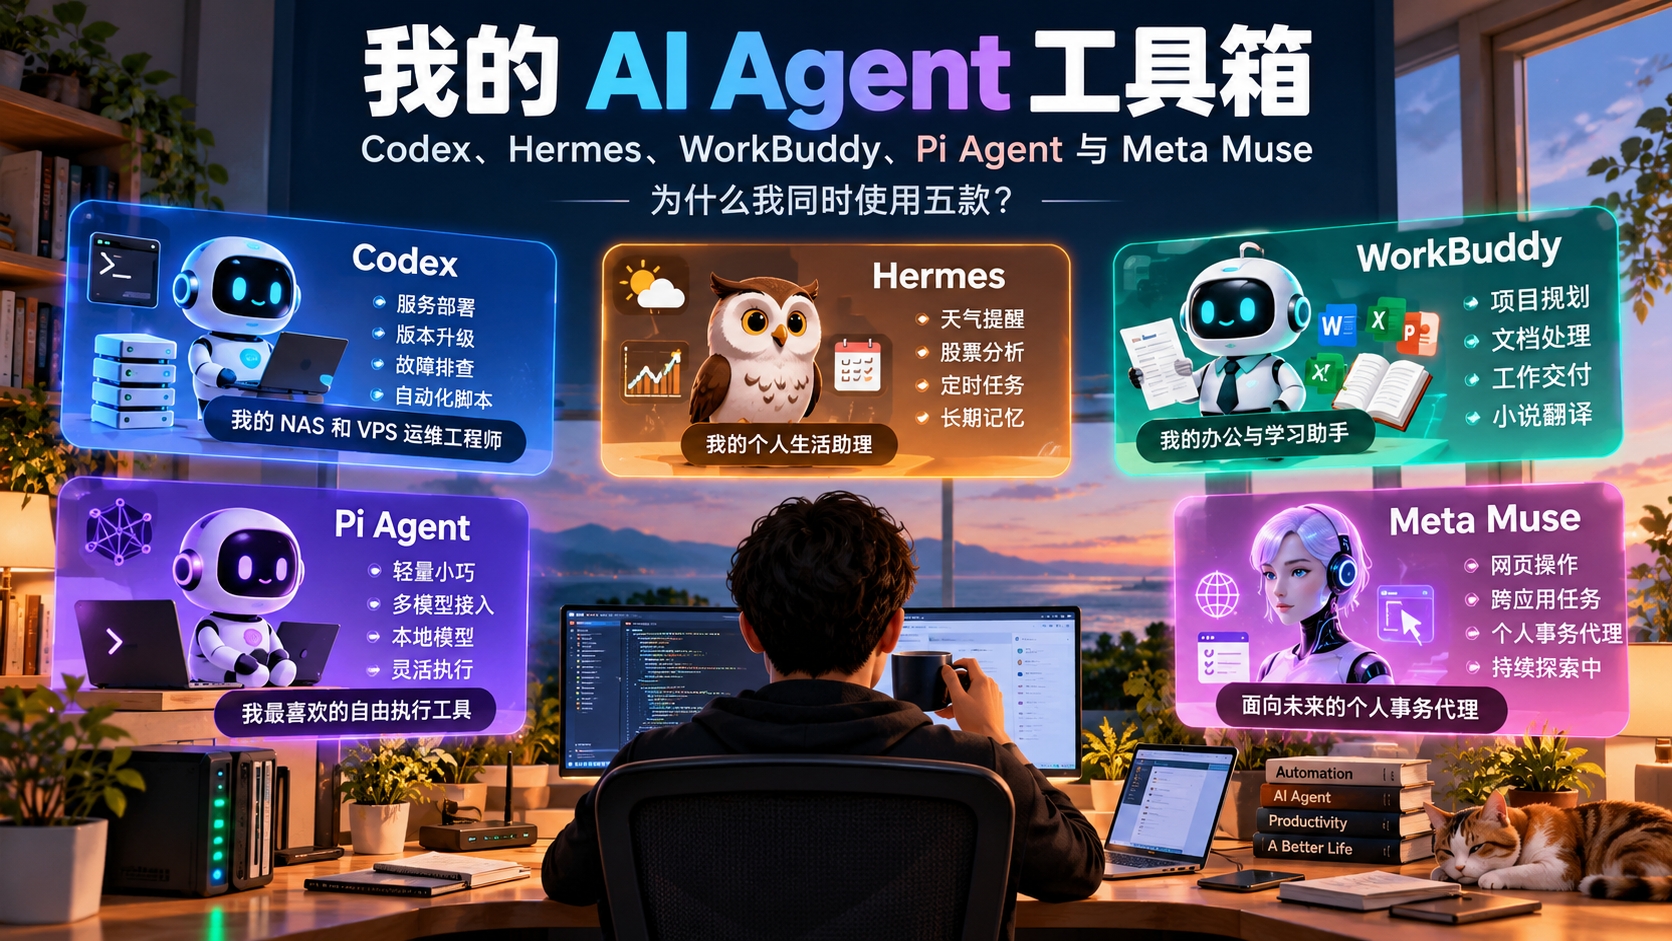
从 NAS、VPS 运维,到个人生活助理、投资分析、办公自动化,再到小说翻译和外语学习,我逐渐建立起了一套由五款 AI Agent 组成的个人 AI 工作体系。它们看起来功能相似,但在实际使用中,各自有着不同的优势和定位。一、写在前面:我的 AI Agent 使用现状最近一段时间,我使用 AI 的方式发生了很大的变化。以前使用大模型,更多是打开一个聊天窗口,提出问题,等待回答。现在则不同。越来越多的工作,我已经习惯直接交给 AI Agent 完成。从 NAS 和 VPS 的服务维护,到股票分析、日常提醒、办公项目规划,再到小说翻译和外语学习,AI 已经逐渐融入我的日常工作和生活。目前,我使用的 AI Agent 主要有五款:Codex:NAS 和 VPS 的运维及开发助手。Hermes Agent:长期运行的个人生活助理。WorkBuddy:办公项目规划和文档处理。Pi Agent:轻量化、本地模型驱动的通用执行工具。Meta Muse:目前处于探索和测试阶段。这五款工具的功能存在不少重叠。它们都能够理解自然语言、调用工具、执行命令,部分还支持长期记忆、Skills 和多 Agent
最近在群晖 NAS 上又折腾了一个东西。我之前一直用 Podsync 自动下载一些播客节目,基本上每天都会有新的音频下来,中文比较多,也有一些英文和葡萄牙语的节目。音频下载下来以后,平时当然可以直接听,但是我慢慢发现一个问题。播客这种东西,有的节目特别是存在多人交互的节目,废话比较多,音频不容易快速捕捉到关键需要的内容。所以我就想,既然这些节目已经全部自动下载到 NAS 里面了,能不能干脆再往后走一步:音频下载以后,自动转成文字,然后再通过 AI 整理成比较适合阅读的文章。这样以后一个节目既可以听,也可以看,还可以搜索和长期保存。于是就开始折腾。一开始想直接在 NAS 上跑 Whisper最开始我的想法其实很简单。既然文件都在 NAS 上,那就在 NAS 上部署一个 Whisper,下载完以后直接本地转写。但是检查了一下我的群晖以后,很快就放弃了这个方案。我这台是 DS218+,CPU 是 Intel Celeron J3355,双核。内存之前已经扩展到了大约 10GB,但是没有独立显卡,而且这个 CPU 连 AVX/AVX2 都不支持。小模型其实也不是完全不能跑。问题是,能跑和适合长
一个笨问题假设你在教一个从没见过世面的助手打理你家的事。你告诉它两句话:老王是我爸。 我是小明。然后你问它:老王和小明是什么关系?正常人零点几秒就答出来了。但对一台只会存数据的机器来说,这是个陷阱——它的库里只有两条记录,没有任何一条写着"老王是小明的爸爸"。所以标准答案是:查无此人此关系。要让它答对,传统做法是你再手写一条规则:"如果 A 是 B 的爸爸,且 B 就是提问的人,则 A 是提问者的爸爸。"能用,但你很快会发现这条路走不通——爷爷、外甥、堂表兄弟、连襟、儿媳的妹夫,中国亲戚关系能把人绕死,你得写几百条。而且换个领域(比如公司的股权关系、疾病的分类体系、电信的资费结构),你又得从头再写几百条。本体推理想解决的,就是这件事:让机器只靠少量的概念定义,自己推出海量你没明说的结论。本体是什么:给世界画一张骨架图"本体"这个词听着玄,其实是从哲学里借的。哲学里的本体论研究"世界上到底存在什么",计算机借来之后,意思务实多了:把一个领域里有哪些概念、概念之间什么关系、有哪些不可违反的规矩,用机器能读懂的方式写清楚。拿家庭举例,你要写的东西大概是这样:有哪些类:人、男人、女人谁包含谁:
walker
万事随性而为,因好而研,因趣而学,从心所欲。脱离依赖,谋划将来,避免经济之险,迈向希望之光。