概要
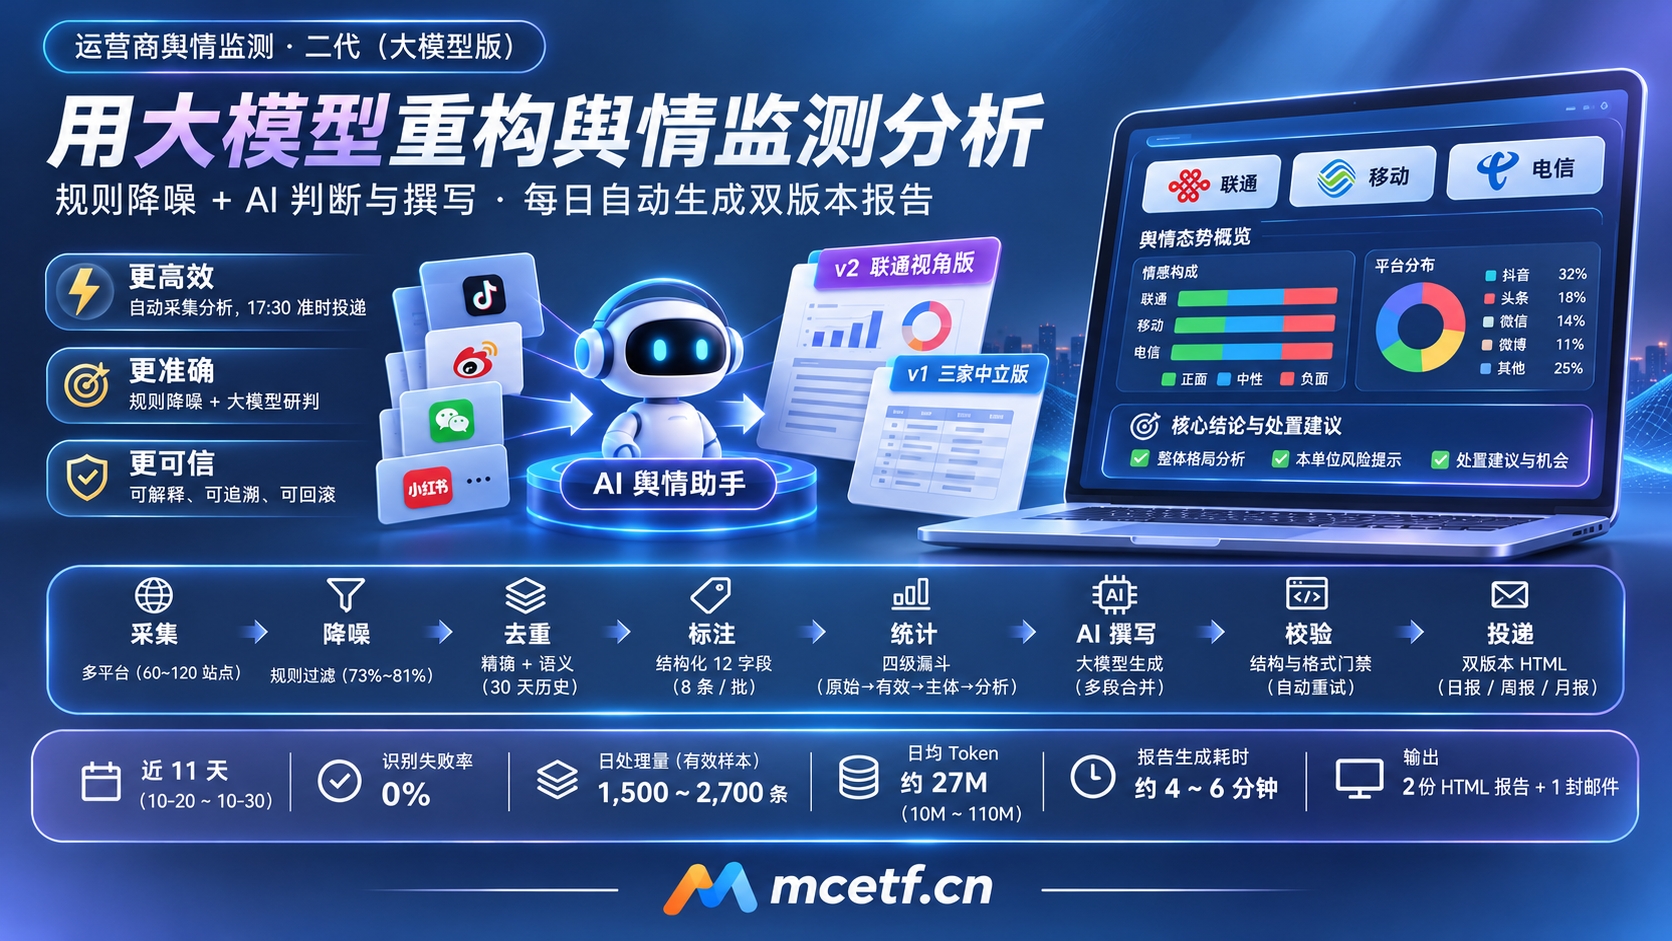
二代舆情系统已实现每天 17:30 自动完成“采集 → 分析 → 报告 → 投递”全链路,近 11 天(10-20 至 10-30)识别失败率为 0。分工原则:规则负责降噪,大模型负责判断与撰写。
| 项目 | 内容 |
|---|---|
| 系统 | 运营商舆情监测分析系统 · 二代(大模型版 / AI助理-舆情助手) |
| 记录依据 | 2026 年 10 月技术评审材料 |
| 监测范围 | 电信 / 联通 / 移动,抖音、头条、微信、微博、小红书、快手、贴吧、投诉平台等 60\~120 个站点 |
| 代码规模 | 约 8,100 行;核心模块 fetcher / noise\_filter / dedup / annotate / ai\_client / stats / report / mail\_v2 |
| 日处理量 | 原始抓取数万条,有效样本 1,500\~2,700 条 |
| 产出 | 每期 2 份响应式 HTML 报告,一封邮件送达 |
| 日均 token | 约 27M(中位),区间 10M\~110M |
背景与演进
二代保留了一代的采集能力,把分析环节整体替换为大模型,目标是人只看结论与建议。
人工处理的三个痛点:
- 看不完:单日原始抓取可达数万条,70%\~80% 与运营商业务无关。
- 判不准:同一事件多平台转载,人工难以合并;情感与归属判断主观。
- 写不快:日报、周报、月报结构固定,人工撰写耗时长。
| 版本 | 分析方式 | 特点 |
|---|---|---|
| 二代 · AI助理-舆情助手(当前) | 规则降噪 + 大模型判断与撰写 | 结构化、可解释 |
| 一代 · 规则引擎版 | 关键词 / 正则聚类 | 判断粒度粗 |
总体架构与设计原则
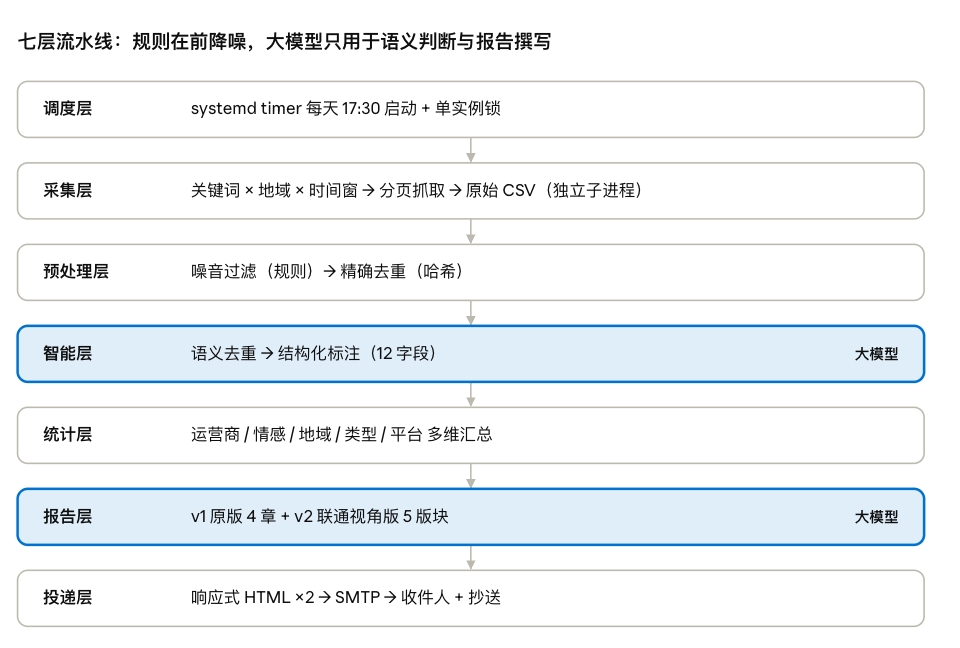
系统按七层串行处理,只有智能层和报告层调用大模型,降噪、去重、统计、校验全部由代码完成。
| # | 原则 | 落地方式 |
|---|---|---|
| 1 | 只标记不删除 | 噪音 / 重复行保留原行,仅打标记,规则调整后可重算 |
| 2 | 采集与分析解耦 | 采集为独立子进程,分析故障不影响数据沉淀 |
| 3 | 约束写在提示词,保证靠代码 | AI 只负责判断,枚举 / 格式 / 结构由程序校验 |
| 4 | 宁可漏发,不可错发 | 报告结构不合格不发送,只向管理员告警 |
| 5 | 失败必留痕 | 接口异常落证据日志,AI 失败计数、阶段耗时全程可查 |
| 6 | 一切可回滚 | 每次代码变更前备份原文件(带时间戳) |
处理流程与数据漏斗
10-30 实测:约 6.5 万行原始数据,最终得到 1,793 条有效样本;规则层剔除量最大且不消耗 AI。
| 环节 | 处理量(10-30 实测) |
|---|---|
| 原始抓取 | 约 6.5 万行 |
| 噪音过滤 | 剔除 73.5%(约 4.8 万行) |
| 精确去重 | 合并 1,463 条 |
| 语义去重 | 合并 1,071 条 |
| 最终有效样本 | 1,793 条 |
9 步数据流:
- 噪音过滤:命中即标记跳过。
- 精确去重:哈希相同保留最早一条。
- 语义去重:含 30 天历史比对。
- 结构化标注:8 条/批 × 12 字段。
- 统计口径漏斗:原始 → 有效 → 主体 → 分析。
- AI 撰写:分段生成后合并。
- 结构校验:缺失小节带提示重试。
- 双版本渲染:v1 + v2 响应式 HTML。
- 邮件投递:一次运行一封邮件。
四级统计口径(报告只基于最后一级):
- 原始:抓取到的全部数据。
- 有效:AI 识别成功且非重复。
- 主体:剔除运营商为“无”的条目。
- 分析:再剔除问题大类为“其他”的条目。
核心模块实现
降噪规则(noise\_filter)
规则按判定顺序即优先级执行,全部配置化,实测单日过滤 73%\~81% 的无关内容。
| 顺序 | 规则类别 | 作用 | 规模 |
|---|---|---|---|
| 0 | 强噪音词 hard\_noise | 即使含品牌词也过滤,如“山东移动破碎机” | 18 |
| 1 | 强品牌词 keep\_brand | 命中即保留,绝不判噪音 | 28 |
| 2 | 邻近业务词(泛词 ± 20 字) | 泛词附近出现业务词则保留,如“移动支付手续费” | 4 泛词 + 20 业务词 |
| 3 | 保护词 protect | “××吧”等渠道口语写法保留 | 3 |
| 4 | 噪音特征 drop\_noise | 命中即过滤 | 101 |
两段式去重(dedup)
- 精确去重:标题 + 正文哈希完全相同,保留发布时间最早的一条。
- 语义去重(AI):判断同标题不同正文是否同一事件;单次最多 20 组、单任务 ≤ 18 条;与 30 天历史库比对;按标题缓存。
结构化标注(annotate)
每次 8 条,输出 12 个字段:
| 类别 | 字段 |
|---|---|
| 归属 | 运营商、运营商依据 |
| 内容 | 舆情摘要(≤ 60 字) |
| 地域 | 省份、地市、地区依据 |
| 情感 | 情感倾向、情感验证、与标注是否一致、不一致说明 |
| 分类 | 问题大类(12 类枚举)、问题子类(≤ 8 字) |
地区口径纪律:只取舆情主体或事件发生地。来电归属地、骚扰电话来源地、评论 IP、顺带提及的省份、广告覆盖地一律不算。
报告体系
每期并行产出两个版本:v1 是三家中立的数据详版,v2 以联通为本单位,附处置建议与同业对标。
| 维度 | v1 原版(详细报告) | v2 联通视角版(视图报告) |
|---|---|---|
| 立场 | 三家中立并列 | 联通为“本单位”,移动 / 电信为同业 |
| 结构 | 4 章 | 5 版块(含核心结论卡片 + 附录) |
| 形态 | Markdown → HTML,表格为主 | 设计稿级富样式 → 响应式 HTML |
| 特色 | 全量数据明细、可查证 | 处置建议、关联风险、同业对标与启示 |
| 生成方式 | 4 段 AI 输出 Markdown | 5 段 AI 输出 JSON,由程序渲染 |
v2 版块构成:
- 核心结论:3 条,AI 自由提炼(整体格局 / 本单位风险 / 本单位机会)。
- 01 整体态势:三家运营商卡片、情感构成条形图、平台分布、正负类型热力表。
- 02 联通负面:类型 / 地市分布、负面案例(含处置建议)、关联风险、风险等级。
- 03 联通正面:类型构成、与同业对比的亮点 / 短板、正面案例(含可复用建议)。
- 04 同业案例:移动 / 电信正负案例精选及对联通的启示。
- 附录:山东负面舆情全量清单,按地市归并,含原文链接。
周期规则:每天出日报;周二加周报;每月 2 日加月报。一次运行只发一封邮件,发送记录防重复。
质量门禁与终端适配
报告须过三层门禁才会发送,不合格只告警管理员;终端适配以“邮件附件在手机上能直接打开”为目标。
| 门禁层 | 机制 |
|---|---|
| 提示词层 | 规则块强制“必须输出全部编号小节”,从源头降低漏节概率 |
| 生成层 | 逐段校验必需小节(兼容 2.1、(2.1)、第2.1节写法);缺失带提示重试:段内 6 次 + 段级 2 轮 |
| 发送层 | v1 需 .valid.json 为 true;v2 需各段 failures 为空;不合格不发送,只告警管理员 |
| 发现的问题 | 处理 |
|---|---|
邮件客户端 / 手机附件预览器会剥掉 <style> | 样式全部改为行内 style 属性 |
| 部分移动 WebView 不支持 CSS 变量、color-mix()、calc()、grid | 替换为字面色值、预计算混合色、百分比宽度、块级布局 |
| 附件体积受限(实测 120KB 可达,1.4MB 被拦) | 放弃 PDF 附件,改投 HTML(70\~85KB) |
| 手机端字小、留白多 | 媒体查询 ≤ 600px:正文 17px、边距 10\~11px、表格横向滑动 |
运行成效(10-20 至 10-30,共 11 天)
11 天识别失败率均为 0,日均有效样本 1,500\~2,700 条,报告生成(5 段 AI)约 4\~6 分钟。耗时波动主要来自上游 AI 网关时段性降级,不是本地性能瓶颈。
已知问题与待办
当前有 3 项已知限制,其中全国化采集方案已完成评估、待决策。
| # | 限制 | 影响 | 建议 |
|---|---|---|---|
| 1 | 识别失败条目已写入断点,补跑时不重试 | 少量条目静默缺失 | 失败不写断点,补跑时重试 |
| 2 | 地域词表固定为山东 | 全国化采集需调整关键词策略 | 方案已评估(取消地域限定 + 词组化 + 简称补丁),待决策 |
| 3 | 问题大类“其他”占比偏高(38%\~56%) | 报告长尾较多 | 已按需剔除;后续扩充分类枚举(招聘、号卡、技术实力等) |
下一步:
- [ ] 连续失败熔断 + 延迟补跑,应对网关时段性降级,减少无效调用放大
- [ ] 去重失败写“未判定”、识别失败不写断点,实现补跑自愈
- [ ] 全国化采集方案决策(取消地域限定 + 词组化 + 简称补丁)
- [ ] 扩充问题分类枚举(招聘、号卡、技术实力等),降低“其他”占比