在客服申诉处理中,「定责报告」是否站得住脚,过去全靠人工对着标准逐条核。如果利用ai智能体来实现,往往采用的就是将技能和规则提供给智能体,但是在规则、报告篇幅、证据材料数据量过大的情况,会导致效果的严重下滑,上下文超长后的报错是直观的,更大的问题就是结果不可控制,每次执行因为不知道大模型记住、看到的是哪一部分,结果都是不一致。
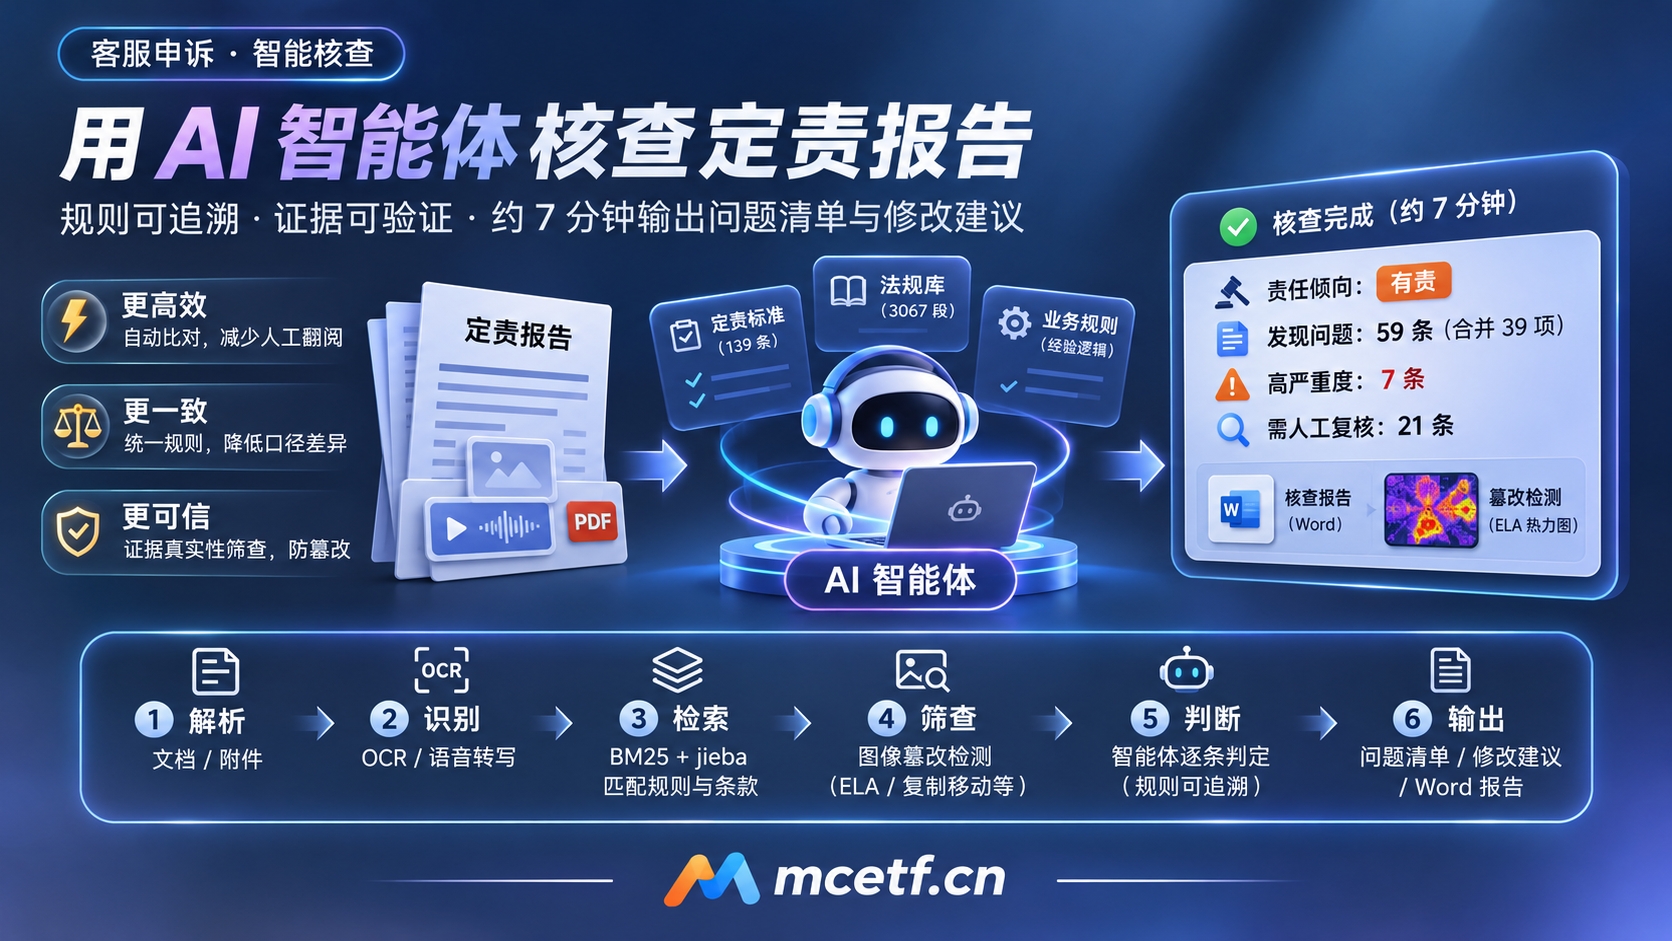
针对这个事情需要做的就是,将规则拆分后逐条规则让ai去确认,然后将最终报告拼接。当然这就是需要把这件事做成了自动化:上传报告和附件,约 7 分钟拿到问题清单和修改建议,每条结论都能追溯到规则和原文。这篇文章从开发思路、技术方案和实际效果三个角度做个总结。
为什么要做
人工核查有三个老问题:
- 慢:对照标准逐条比对、反复翻附件,一份报告要花很长时间。
- 尺度不一:不同人判断口径不同,同类案件结论难统一。
- 证据难辨:截图、录音可能被 PS 或合成,肉眼很难发现。
同时,这类数据涉及用户隐私,项目一开始就定了三条硬约束:
- 数据不出内网:全流程在企业内网完成。
- 只用内部大模型:技能本身不调用任何外部模型,推理交给企业自有的智能体平台。
- 组件开源且离线:OCR、语音转写、篡改检测都选开源方案,本地运行。
这三条约束决定了后面几乎所有技术选型。
开发思路
1. 一次核查,三路并行
把「核查一份定责报告」拆成三个相互独立的比对,再加一路证据真伪筛查:
| 核查方向 | 关注点 |
|---|---|
| 报告 vs 定责标准 | 责任认定与条款引用是否一致 |
| 证据 vs 报告 | 截图、录音与报告描述能否对应 |
| 业务流程 vs 管理规定 | 处置步骤与时限是否符合规定 |
| 疑似篡改筛查 | 图片证据是否有编辑、合成痕迹 |
四路结果合并成一份问题清单,每条问题都定位到原文,并给出可执行的修改方向。
2. 可信优先
大模型最大的风险是「一本正经地编」。在定责这种严肃场景里,我给智能体加了四道约束:
- 判「不符合」必须有确定性规则印证:规则命中是前提,模型不能凭感觉判错。
- 引用必须能在原文找到:改动过数字、日期、否定词的引用一律拒绝。
- 不满足以上条件就降级为「需人工」:证据不足时把判断交还给人。
- 结论原样输出:智能体的补充说明单独成段,不混入结论。
这样每条结论都能回溯到规则和原文,人工复核时有据可依。
3. 规则与代码分离,业务人员能自己维护
规则分三层,维护边界清晰:
| 层级 | 载体与规模 | 怎么更新 |
|---|---|---|
| 定责标准 | 一张 Excel,139 条 | 直接改表;保持四列格式(一级、二级、有责情形、文件依据) |
| 法规库 | 一个 zip 包,3067 段 | 新法规做成 Word / 文本加进包,程序按「第X条」自动拆分 |
| 判断逻辑 | 写在程序里 | 大部分关键词可在配置文件调整;新增一类检查才需改代码 |
判断逻辑是那些「经验规则」,比如超套提醒必须在多少天内发出、哪些附件算有效证据。业务人员用平常话写下「某种情况下应该怎么判」,整理成开发计划后再实现。
技术方案
整体是一条六步流水线:解析、识别、检索、篡改检测都在本地离线完成,只把整理好的结构化「判断包」交给大模型智能体逐条判断。
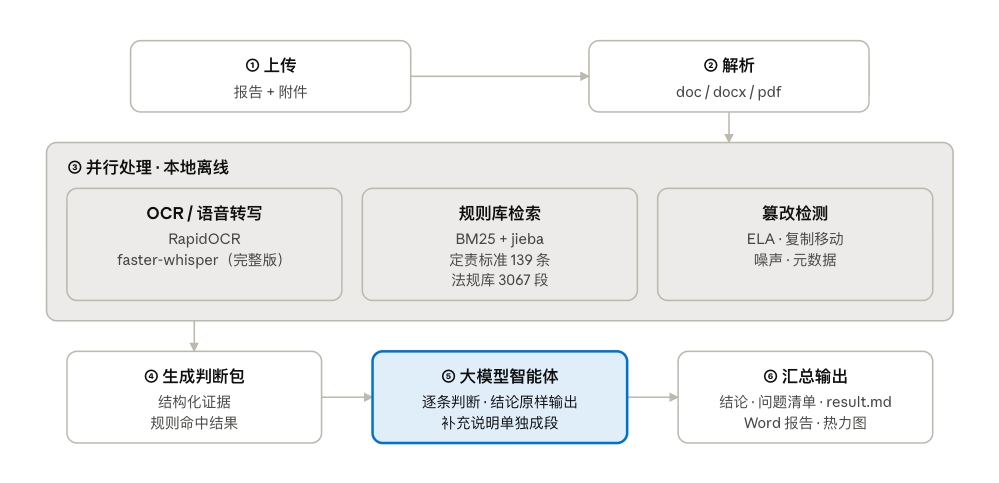
第 ③ 步三路并行,结果汇成判断包;智能体结论原样输出,补充说明单独成段。
技术选型
| 环节 | 选型 | 说明 |
|---|---|---|
| 文档解析 | doc / docx / pdf | 覆盖常见报告格式 |
| OCR | RapidOCR | 开源、可离线,识别截图里的文字 |
| 语音转写 | faster-whisper | 录音证据转文字,本地运行 |
| 规则检索 | BM25 + jieba 分词 | 不依赖向量库,轻量、结果可解释 |
| 篡改检测 | ELA、复制移动检测、噪声分析、元数据检查 | 输出热力图标出可疑区域 |
| 判断引擎 | 企业内部大模型智能体 | 技能本身不调用外部模型 |
规则检索没有用向量检索,而是选了 BM25 + jieba。定责条款和法规条文措辞相对固定,关键词匹配足够准,而且命中结果可以直接展示给人看,正好服务于「判不符合必须有规则印证」的可信机制。
部署形态
技能打成离线安装包,分两个版本:
| 版本 | 安装体积 | 语音转写 | 适用场景 |
|---|---|---|---|
| 精简版 | 约 210MB | 不支持 | 常规核查 |
| 完整版 | 约 760MB | 支持 | 含录音证据的核查 |
安装只需把包传到服务器,让智能体执行安装脚本,再跑一遍自检确认依赖和模型齐全。使用时在聊天窗口上传报告和附件,说一句「核查这份申诉报告」即可,输出结论、问题清单、Word 报告和热力图。
效果
在一个基准案例上实测,技能判定责任倾向为「有责」,共发现 59 条问题,本地处理约 80 秒。
| 指标 | 结果 | 说明 |
|---|---|---|
| 责任倾向 | 有责 | — |
| 发现总数 | 59 条 | 合并展示为 39 项 |
| 高严重度 | 7 条 | 需优先关注 |
| 需人工复核 | 21 条 | 证据不足时主动降级 |
| 本地处理耗时 | 约 80 秒 | 不含智能体逐条判断;端到端约 7 分钟 |
21 条「需人工」看起来不少,但这正是设计意图:模型不确定的地方明确标出来,而不是给一个看似笃定的错误结论。篡改检测在两份图片附件上生成了 ELA 热力图,可疑区域一目了然。
落到日常工作里,预期收益有三点:
- 缩短核查时间:逐条比对和附件核对自动完成,减少重复翻阅。
- 统一判断尺度:以规则库为共同依据,减少人员口径差异。
- 提前拦截问题证据:疑似篡改线索前置提示,避免「带病」报告继续流转。
局限与下一步
方向是从规则自助更新、调用系统 agent 起步,逐步把申诉处理做得更智能。但定位不会变:它是辅助人工复核的工具,不代替最终判断。